Statisztika döntéshozóknak
Simpson-paradoxon: amikor az átlag félrevezet
Minden szegmens javul, az összesített szám mégis romlik. Hogyan fordíthatja meg egy KPI-t az összetétel eltolódása, mit tanítanak a klasszikus esetek, és hogyan olvassuk biztonságosan a saját dashboardjainkat?
A csapat elindít egy újratervezett fizetési folyamatot (checkoutot). Egy negyedév múlva a dashboard azt mutatja, hogy a konverzió csökkent, 8,3%-ról 5,8%-ra. A kézenfekvő következtetés az, hogy vissza kell állni a régire. Ha viszont ugyanezeket a számokat eszköztípus szerint bontjuk, az új checkout asztali gépen és mobilon is jobban konvertál.
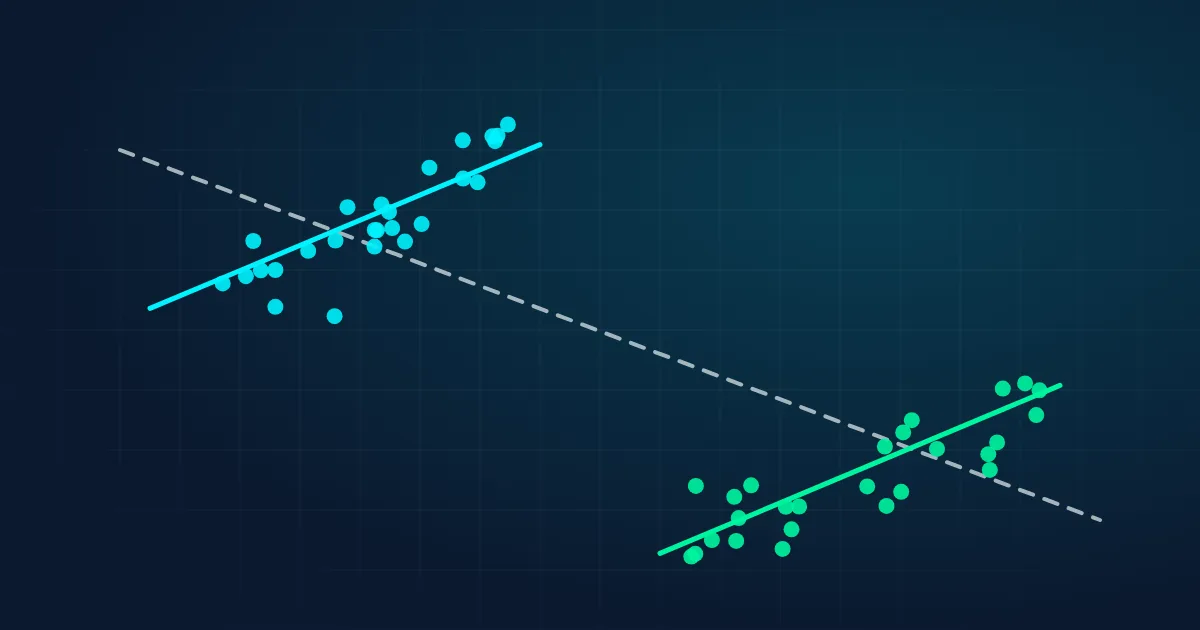
A táblázatban nincs hiba. A két állítás egyszerre igaz. Ez a Simpson-paradoxon: egy trend, amely az adatok minden csoportjában megjelenik, eltűnhet, sőt meg is fordulhat, ha a csoportokat összevonjuk. Ez az egyik leggyakoribb oka annak, hogy egy ésszerűnek látszó üzleti riport rossz döntéshez vezet.
Mi a Simpson-paradoxon?
Egy összesített arány a csoportonkénti arányok átlaga, a csoportok méretével súlyozva. Az összesített szám tehát kétféle okból változhat: azért, mert a csoportokon belüli arányok változtak, vagy azért, mert a csoportok összetétele (a mix) változott. Ha az összetétel egy természeténél fogva gyengébb eredményű csoport felé tolódik, az összesített érték akkor is csökkenhet, ha közben minden csoport javul.
A paradoxon Edward H. Simpson statisztikusról kapta a nevét, aki 1951-ben írta le, bár mások már korábban is észrevették a jelenséget. Nem a kis minták vagy a rossz adatok sajátossága. Egyenesen következik a súlyozott átlagok számtanából, és nagy, tiszta adatbázisokban ugyanúgy előfordul, mint a rendezetlenekben.
Klasszikus példa: két vesekő-kezelés
Egy ismert, 1986-os vizsgálatban két vesekő-kezelést hasonlítottak össze: a nyílt műtétet (A kezelés) és egy kevésbé invazív eljárást, a perkután nephrolithotomiát (B kezelés). Az összes beteget együtt nézve a kevésbé invazív eljárás tűnt jobbnak.
| Betegek | A kezelés: nyílt műtét | B kezelés: kevésbé invazív |
|---|---|---|
| Kis kövek | 93% (87-ből 81) | 87% (270-ből 234) |
| Nagy kövek | 73% (263-ból 192) | 69% (80-ból 55) |
| Összes beteg | 78% (350-ből 273) | 83% (350-ből 289) |
A nyílt műtét a kis és a nagy köveknél is sikeresebb volt, összességében mégis gyengébbnek látszott. Az ok az összetétel: az orvosok a nehezebb, nagy köves eseteknél inkább a nyílt műtétet választották, a könnyebbeknél pedig a kíméletesebb eljárást. Az A kezelés kapta a nehezebb betegeket, ezért lett rosszabb az összesített átlaga.
A leghíresebb eset: a berkeley-i felvételi, 1973
1973 őszén a Kaliforniai Egyetem (Berkeley) a mesterképzésekre jelentkező férfiak nagyjából 44%-át, a nők 35%-át vette fel. Ez első ránézésre egyértelmű bizonyítéknak tűnt a nőkkel szembeni hátrányos megkülönböztetésre. Amikor azonban a statisztikusok tanszékenként elemezték az adatokat, a különbség eltűnt: a legtöbb tanszéken a nőket hasonló vagy kissé magasabb arányban vették fel, mint a férfiakat.
A Science folyóiratban 1975-ben megjelent magyarázat szerint a nők gyakrabban jelentkeztek olyan, nagyon túljelentkezett tanszékekre, ahol mindenkinek alacsony volt a felvételi esélye, a férfiak pedig gyakrabban olyanokra, ahol a jelentkezők többségét felvették. Az összesített különbséget az okozta, hogy hová jelentkeztek az emberek, nem az, hogyan bántak velük a tanszékek. Ez nem dönt el minden méltányossági kérdést, de jól mutatja, mennyire félrevezető volt az egyetlen összesített szám.
Próbálja ki: hogyan fordíthatja meg a forgalmi mix a konverziót?
Vissza a checkout újratervezéséhez. Az alábbi példában (szemléltető, kitalált számokkal) az új checkout a harmadik negyedévben mindkét eszköztípuson jobban konvertál, mint a régi a második negyedévben: asztali gépen 11,0% a 10,0%-kal szemben, mobilon 3,6% a 3,0%-kal szemben. A második negyedévben a forgalom negyede érkezett mobilról. A harmadikban egy közösségimédia-kampány rengeteg új mobilos látogatót hozott. A csúszkával állítsa be a Q3 mobilos arányát, és figyelje az összesített értéket.
Ha a Q3 mobilos aránya ugyanúgy 25%, mint a Q2-ben, az új checkout összességében is nyer: 9,2% a 8,3%-kal szemben. Nagyjából 37% mobilos forgalom felett viszont az összesített érték ellene fordul, pedig a teljesítményében semmi nem változott. A kampány több mobilos látogatót hozott, a mobilos látogatók pedig bármilyen checkouton kevésbé konvertálnak.
Miért történik ez? Minden átlagnak vannak súlyai
Σ (a csoport részaránya × a csoporton belüli arány)
A példában: Q3 összesen = 30% × 11,0% + 70% × 3,6% = 5,8%. Q2 összesen = 75% × 10,0% + 25% × 3,0% = 8,3%.
A Simpson-paradoxon akkor jelenik meg, ha két feltétel egyszerre teljesül. Az egyik, hogy a csoportok alaperedményei nagyon eltérnek egymástól (az asztali gépes forgalom sokkal jobban konvertál, mint a mobilos). A másik, hogy a csoportok nem egyforma arányban szerepelnek az összehasonlított adatokban (Q3-ban sokkal több a mobilos forgalom, mint Q2-ben). Ha egy változó egyszerre befolyásolja, hogy ki melyik csoportba kerül, és azt is, hogy mi lesz az eredmény, az összesített összehasonlítás két hatást mos össze.
Hasznos szokás a teljes változást két részre bontani. Ha a Q3 szegmensenkénti konverzióját a Q2 forgalmi összetételére alkalmazzuk, Q3 9,2%-on konvertálna: ez +0,9 pontos arányhatás. A maradék −3,3 pont a mixhatás, amelyet kizárólag a mobil felé tolódás okozott. A dashboard csak a kettő összegét mutatta: −2,4 pontot.
Hol bukkan fel az üzleti adatokban?
- Konverzió és marketing. Az eszköztípus, a csatorna, az ország, valamint az új és a visszatérő látogatók más-más alapkonverzióval rendelkeznek. Egy kampány, amely megváltoztatja a forgalom összetételét, bármelyik irányba elmozdíthatja az összesített értéket.
- Átlagos kosárérték és árrés. Egy termékcsalád minden régióban növelheti az árrését, miközben a cég átlagos árrése csökken, mert az értékesítés egy alacsonyabb árrésű régió felé tolódott.
- Értékesítési teljesítmény. Egy értékesítő, aki főleg nagy, nehéz ügyleteken dolgozik, összességében alacsonyabb sikerességi arányt mutathat, mint egy kollégája, pedig a kis és a nagy ügyletek szegmensében is gyakrabban nyer, vagy épp fordítva.
- Minőségi és ügyfélszolgálati mutatók. A nehezebb eseteket vállaló kórházak, call centerek és supportcsapatok a nyers átlagokban rosszabbnak tűnhetnek, akkor is, ha esetről esetre jobban teljesítenek. Ezért igazítják a tisztességes összehasonlítások az esetösszetételhez az adatokat.
- Lemorzsolódás és megtartás. Az összesített lemorzsolódás nőhet, miközben minden előfizetési csomagban csökken, ha az ügyfélkör az olcsóbb, természetüknél fogva gyakrabban lemondott csomagok felé tolódik.
Akkor melyik szám a helyes?
A Simpson-paradoxon nem azt jelenti, hogy a szegmentált számok mindig helyesek, az összesítés pedig mindig hamis. A válasz a kérdéstől és attól függ, hogyan kapcsolódnak egymáshoz a változók.
Ha a csoportosító változó egyszerre befolyásolja, ki kapja a kezelést, és mi lesz az eredmény (mint a vesekövesek esetében a kő mérete), akkor a csoportokon belül kell összehasonlítani. Ha viszont a csoportosító változó maga is a döntésünk következménye, lehet, hogy az összesített szám a helyes. Ha például az új checkout miatt hagyták ott az asztali gépes felhasználók az oldalt, és tértek vissza mobilról, akkor az összetétel eltolódása az újratervezés hatásának része, és az összesített visszaesés valódi. A számítógép ezeket a helyzeteket pusztán a számokból nem tudja megkülönböztetni: ismerni kell, hogyan keletkeztek az adatok. Ezt az ok-okozati szemléletet Judea Pearl The Book of Why című könyve magyarázza el érthetően.
Gyakorlati ellenőrzőlista
- Minden kiemelt KPI-t bontsunk a fő összetételi dimenziók szerint, mielőtt döntünk: eszköztípus, csatorna, régió, ügyfélszegmens, termékcsoport.
- A nyers szám mellett mutassunk mixkorrigált értéket is. Mindkét időszak szegmensenkénti arányát alkalmazzuk ugyanarra a rögzített összetételre. Ha a korrigált és a nyers változás ellentétes irányba mutat, a fő számot az összetétel mozgatja.
- Válasszuk szét az arányhatást és a mixhatást a havi és negyedéves értékeléseken. Ezeknek általában más a gazdája: az arányokért többnyire a termékcsapat felel, az összetételért gyakran a marketing és az értékesítés.
- Ahol lehet, randomizáljunk. Egy rendes A/B tesztben a véletlen besorolás mindkét csoportban azonosan tartja az összetételt, így ez a probléma eleve nem lép fel. Az előtte–utána összehasonlításoknak nincs ilyen védelmük.
- Kérdezzük meg, hogyan alakultak ki a csoportok. Ha a bontás alapjául szolgáló változót maga a döntésünk is okozhatta, gondoljuk át alaposan, mielőtt „korrigálunk” rá.
Ha az összesítés és a részei ellentmondanak egymásnak, nem az adat hibás. Azt jelzi, hogy egyszerre két különböző dolog változott.
A tanulság
Minden átlag mögött ott van egy összetétel. Az esetek többségében ez stabil, és az átlag jó összefoglaló. Ha viszont az összetétel elmozdul egy kampány, egy új piac, egy árváltozás vagy egy másfajta ügyfélkör miatt, az átlag akár az ellenkezőjét is mondhatja annak, ami az egyes csoportokon belül történt. Ha a számokat bontjuk, korrigálunk az összetételre és végiggondoljuk az ok-okozati viszonyokat, ebből a csapdából az adatok egyik legértékesebb felismerése lesz.
Források és további olvasnivaló
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society, Series B, 13(2), 238–241.
- Bickel, P. J., Hammel, E. A., & O'Connell, J. W. (1975). Sex bias in graduate admissions: Data from Berkeley. Science, 187(4175), 398–404.
- Charig, C. R., Webb, D. R., Payne, S. R., & Wickham, J. E. A. (1986). Comparison of treatment of renal calculi by open surgery, percutaneous nephrolithotomy, and extracorporeal shockwave lithotripsy. British Medical Journal, 292(6524), 879–882.
- Pearl, J., & Mackenzie, D. (2018). The Book of Why: The New Science of Cause and Effect. Basic Books.